 Synapse
Open Synapse
A clinical multimodal vision language foundation model with fine-grain explainability
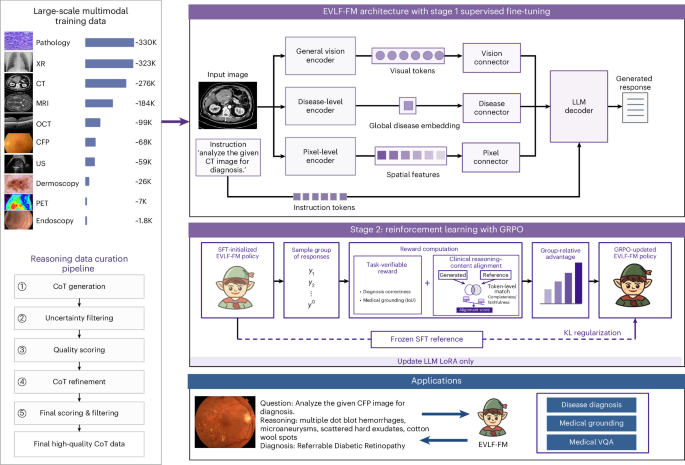
A multimodal vision language foundation model, EVLF-FM, integrates extensive clinical data and advanced training techniques, achieving superior diagnostic accuracy and explainability across diverse imaging modalities, enhancing clinical decision-making through robust reasoning and interpretability.